JDK 7、JDK 8 的 HashMap 底层实现有何不同?
查看完整题解
参考回答
直接回答
典型 OpenJDK 7 HashMap 用数组加链表;OpenJDK 8 增加红黑树桶,以改善严重碰撞时的搜索,并调整哈希扰动与扩容迁移方式。比较必须限定版本:以下历史实现分别核对 jdk7-b147 与 jdk8-b132,不能把所有 7u 更新都概括成完全一样。Java 21 沿用数组、链表与树桶的总体思路。
讲清原理
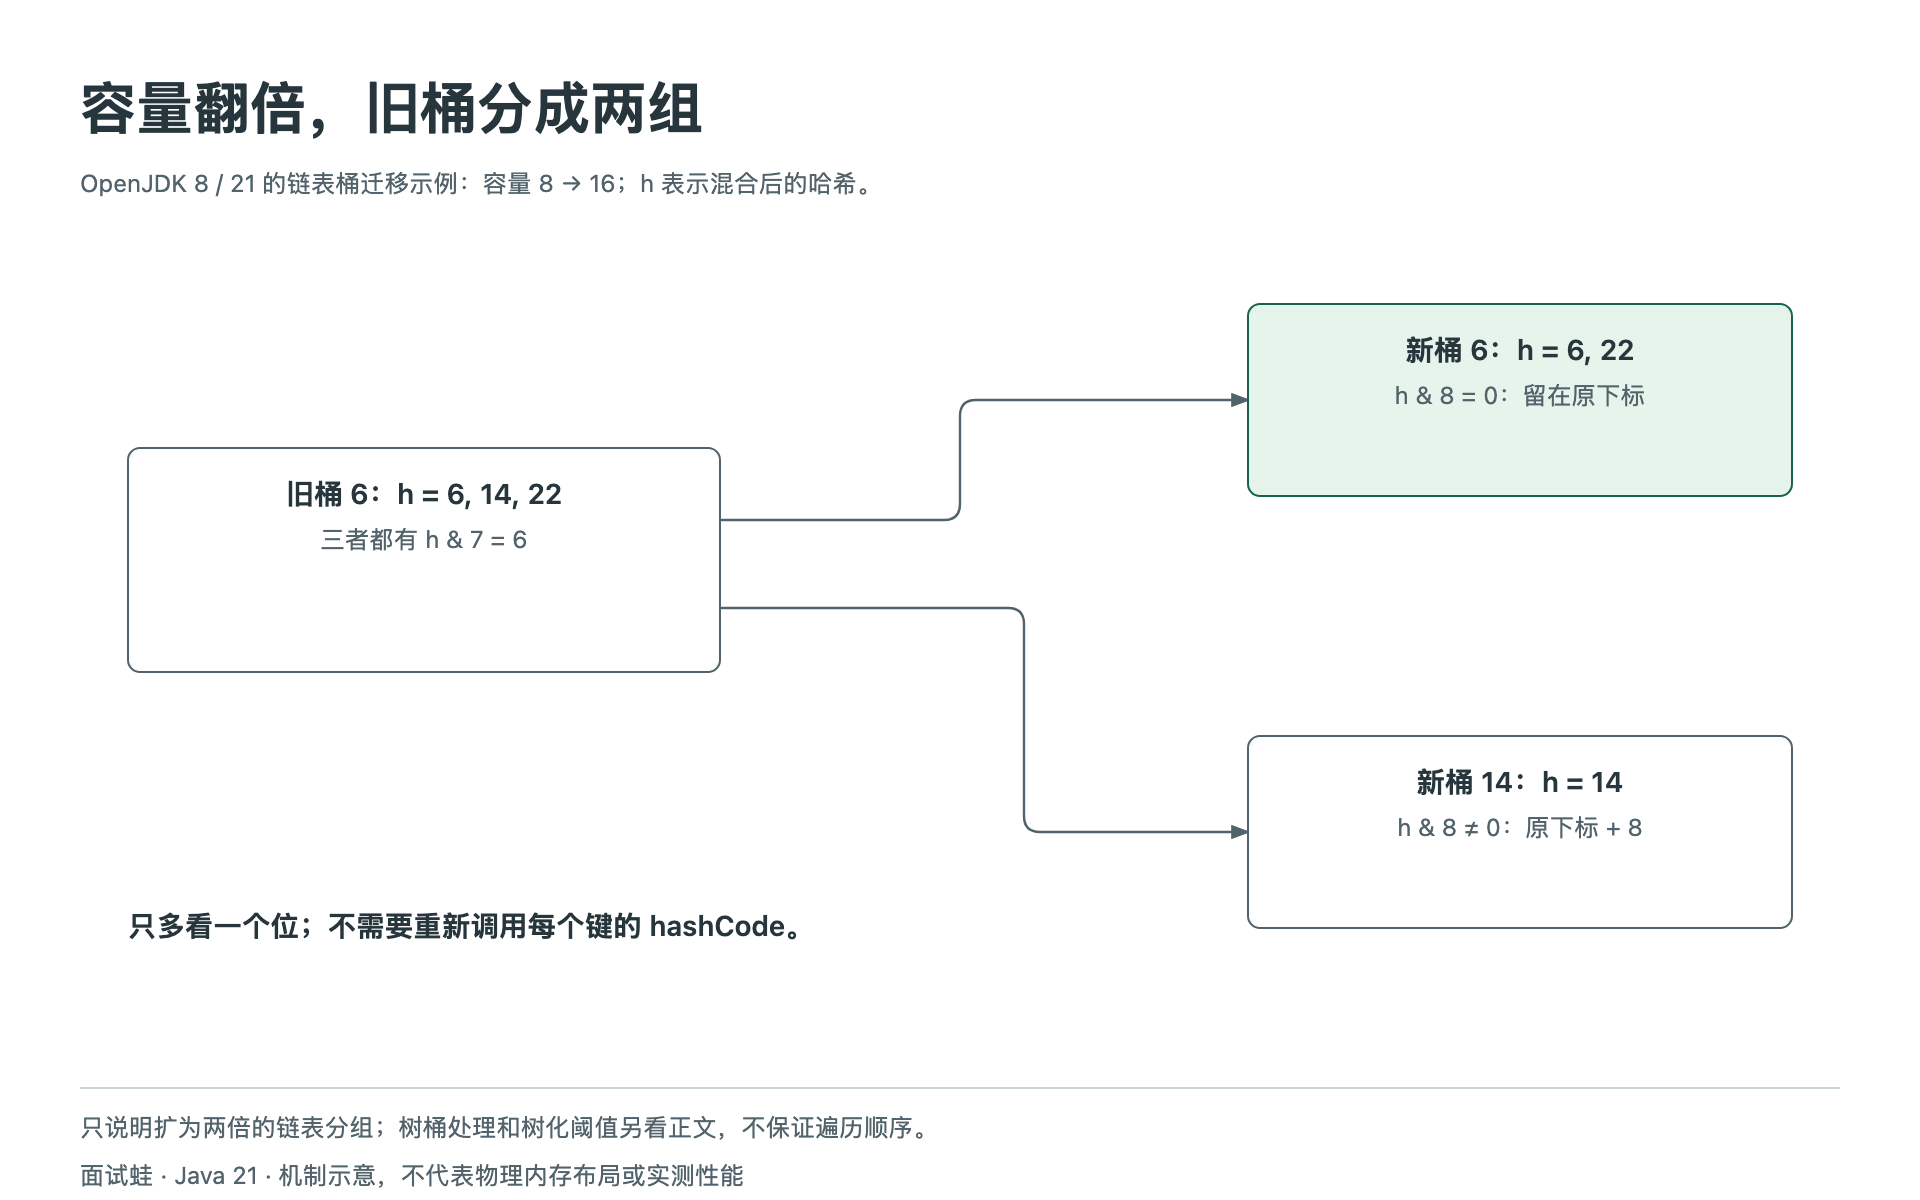
JDK 8 用 h 与 h 的高 16 位异或来混合哈希。容量为二次幂,扩为两倍时,旧桶元素根据新增的一个二进制位,留在原下标或移到“原下标加旧容量”;链表分组时保留组内相对次序。相比所核对 JDK 7 的迁移路径,不能继续照搬旧式链表头插迁移解释。
树化阈值常量为 8,最小树化数组容量为 64;进入检查路径后,数组太小时优先扩容。具体插入路径还影响检查发生时刻,所以“第 8 个元素一定立即树化”不准确。这些常量不是 Map 接口保证。
例子与易错点
旧容量 8 时,混合哈希为 6、14、22 的元素都在桶 6;扩为 16 后,6 和 22 仍在桶 6,14 去桶 14。
历史上的不安全并发扩容问题不能推出 Java 21 HashMap 已经线程安全。数据竞争、丢更新和可见性仍需正确同步解决;不应编写竞态程序去期待必现某种旧故障。
相关题:第 2 题、第 14 题、第 42 题、第 44 题。
这道题,你掌握得怎么样?
掌握程度由你主动标记,阅读和收藏不会自动改变状态。