怎样处理超过一万条的分页?
查看完整题解
参考回答
直接回答
默认 from+size 受 index.max_result_window 限制,通常为 10000。可以调整它,但把上限拉高会放大分片候选排序和协调内存成本。连续向后浏览更适合稳定排序加 search_after,需要一致视图时配合 PIT。
讲清原理
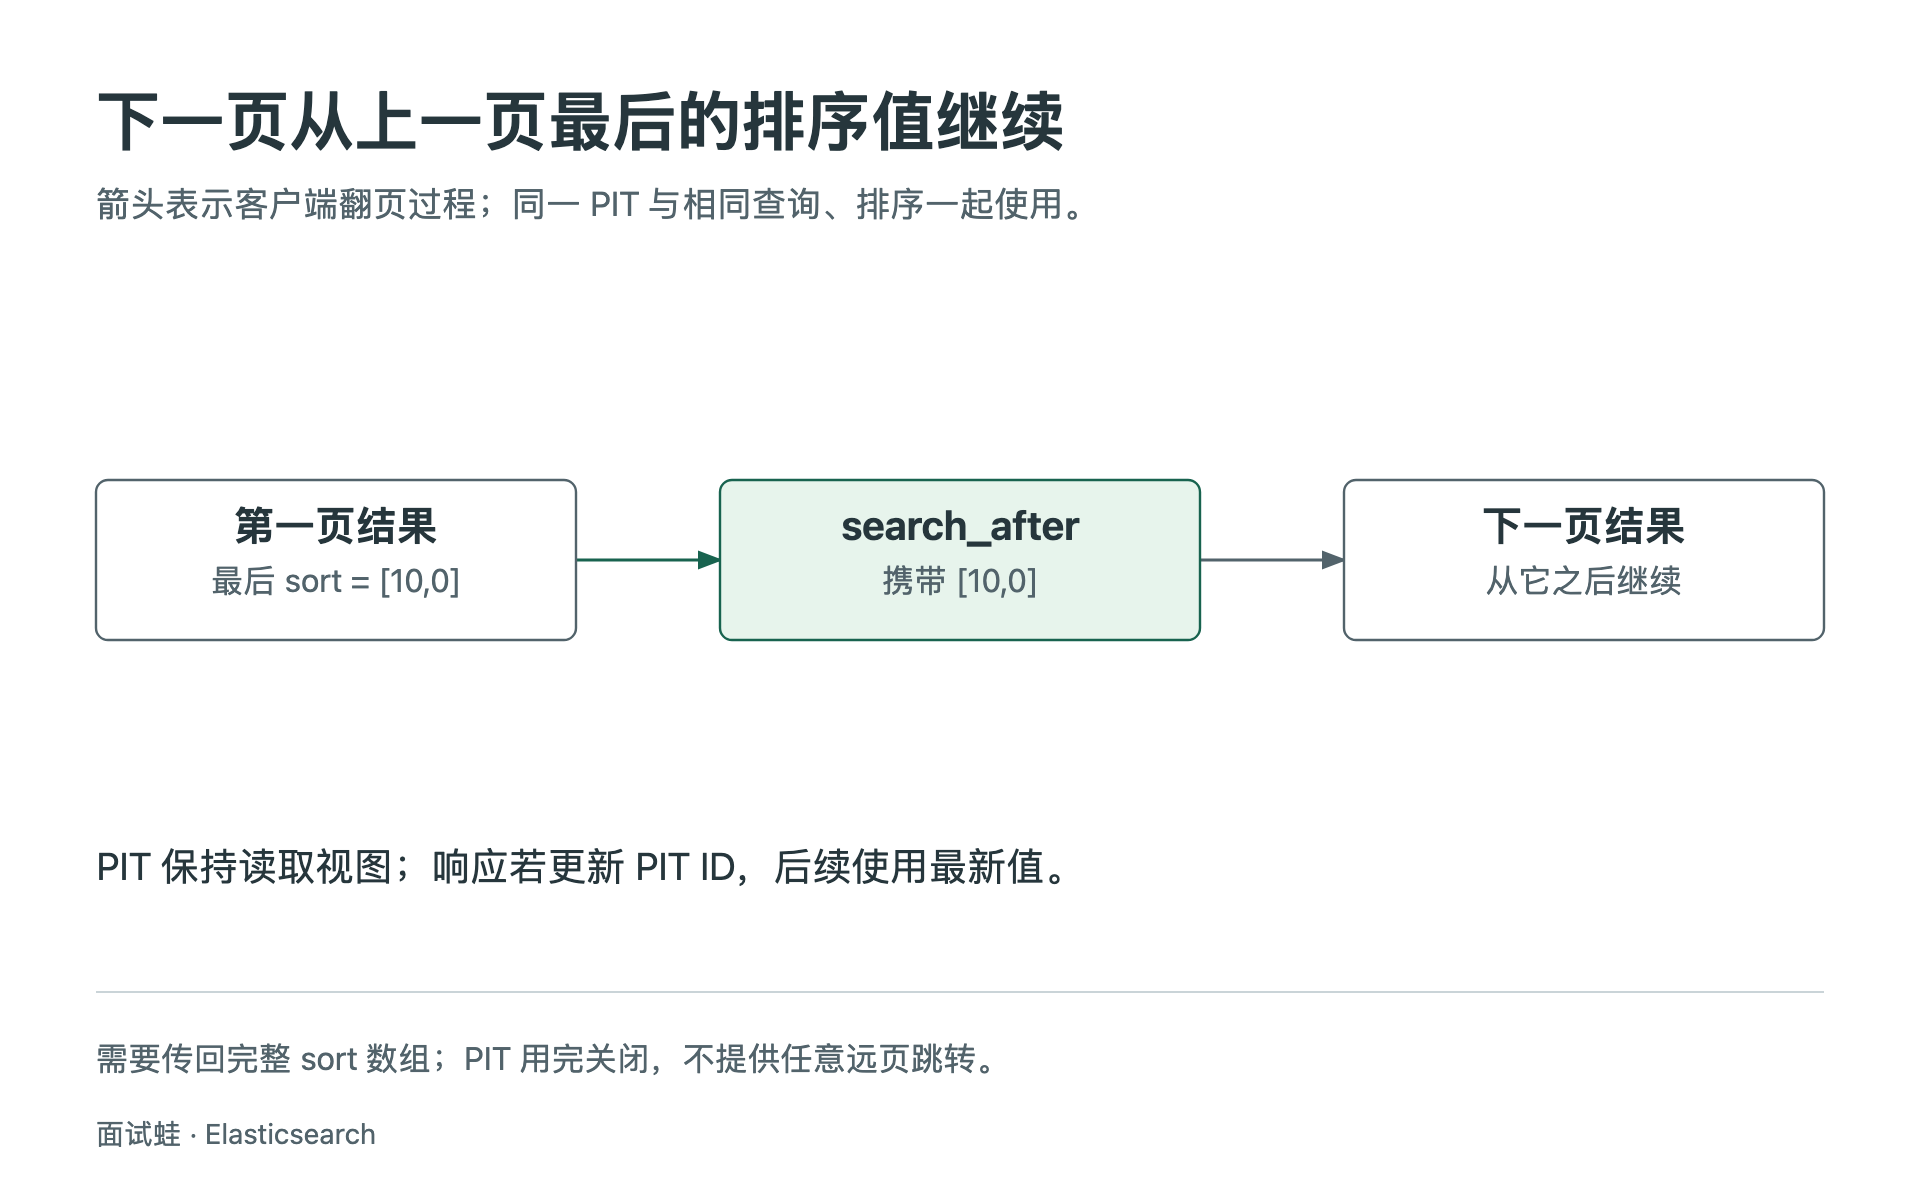
search_after 带上上一页最后一条的完整排序值,取接下来的结果。排序必须稳定并处理并列值;PIT 固定读取视图,避免翻页期间刷新把结果挤来挤去。它不能像页码那样直接跳到任意远页。
例子与易错点
下面以已打开 PIT 的 ID 与上一页返回的 sort 数组为前提。有效 PIT 可能在响应中更新,继续使用最新 ID,结束关闭 PIT。
{
  "size": 1,
  "pit": {
    "id": "PIT_ID_FROM_OPEN_RESPONSE",
    "keep_alive": "1m"
  },
  "sort": [
    {
      "price": "asc"
    },
    {
      "_shard_doc": "asc"
    }
  ],
  "search_after": [
    10,
    0
  ]
}
scroll 仍可用于批量遍历等场景,但不作为面向用户深分页的默认方案。
这道题,你掌握得怎么样?
掌握程度由你主动标记,阅读和收藏不会自动改变状态。