怎样设计分布式缓存与数据存储?
先说出你的答案
定义边界、关键机制、一个反例;P8题再补容量、失败与验证。
查看完整题解
参考回答
直接回答
先明确数据库等权威来源与缓存副本的角色,再设计键、分区、过期、更新与故障策略。Redis等可提供共享数据能力,Boot负责相关集成,但多副本不会天然保持与数据库同步,也不意味着可以把缓存当作永不丢失的唯一业务事实。
讲清原理
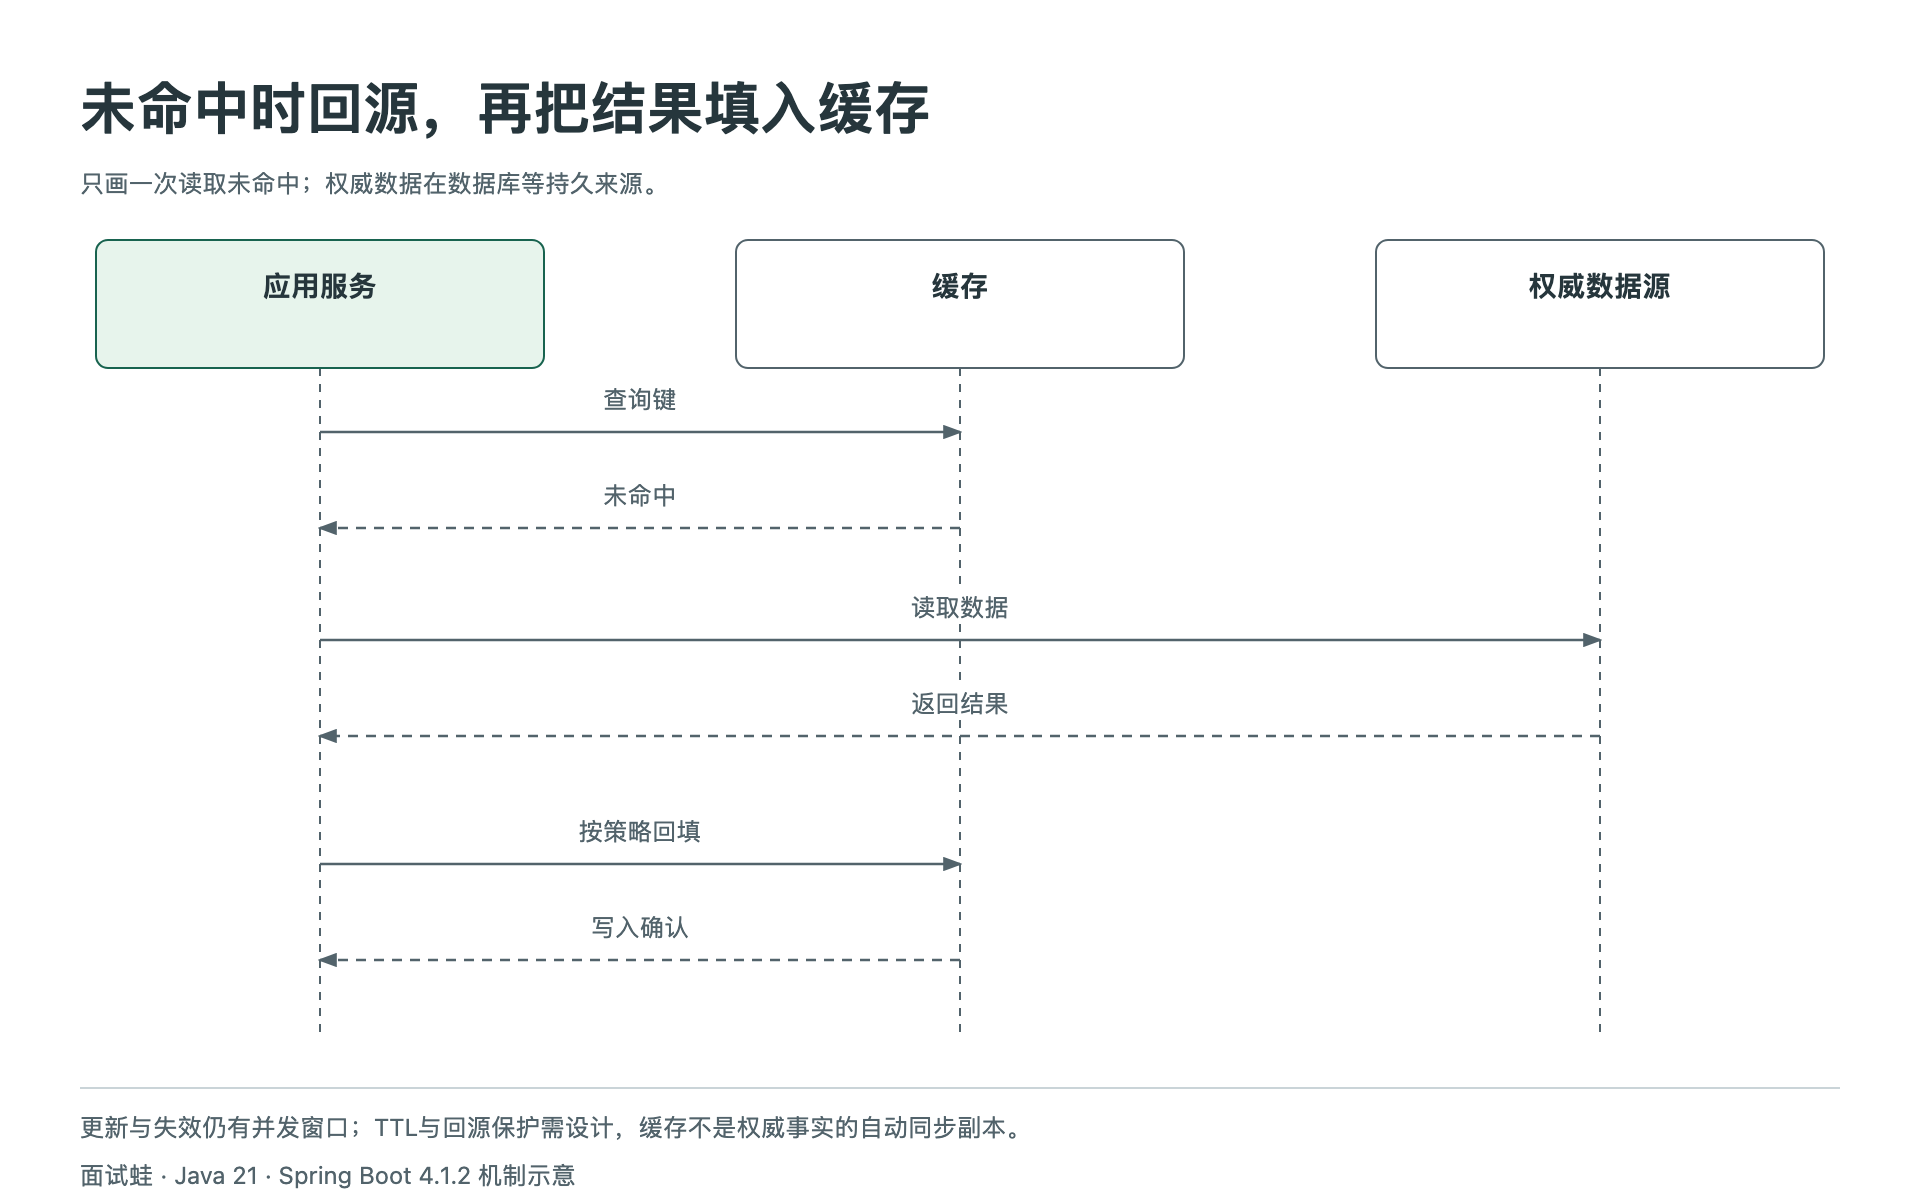
常见cache-aside先查缓存、未命中再查库并回填;更新时通常在事务成功后处理缓存失效。并发读写仍可能产生陈旧回填,强一致要求需要额外版本、协调或不同读路径,不能只写“删缓存”就证明没有窗口。
缓存穿透、热点和同时过期要按负载处理,避免故障时无节制回源。TTL、空值、序列化和容量策略应是明确契约,不把所有键都永久保留。
例子与易错点
为关键读取定义可接受陈旧程度,验证更新、并发与缓存不可用场景。一个内存缓存代理测试只证明注解调用路径,不能代表Redis持久化、复制或网络分区已经验收。
相关题:第 45 题、第 51 题、第 54 题。
和评分标准对照,你能独立回答到哪一步?
自评会安排下一次复习,不保存你的口述内容。
这道题,你掌握得怎么样?
掌握程度由你主动标记,阅读和收藏不会自动改变状态。