Splunk 从收到数据到返回搜索结果,经历了什么?
先说出你的答案
定义边界、关键机制、一个反例;P8题再补容量、失败与验证。
查看完整题解
参考回答
直接回答
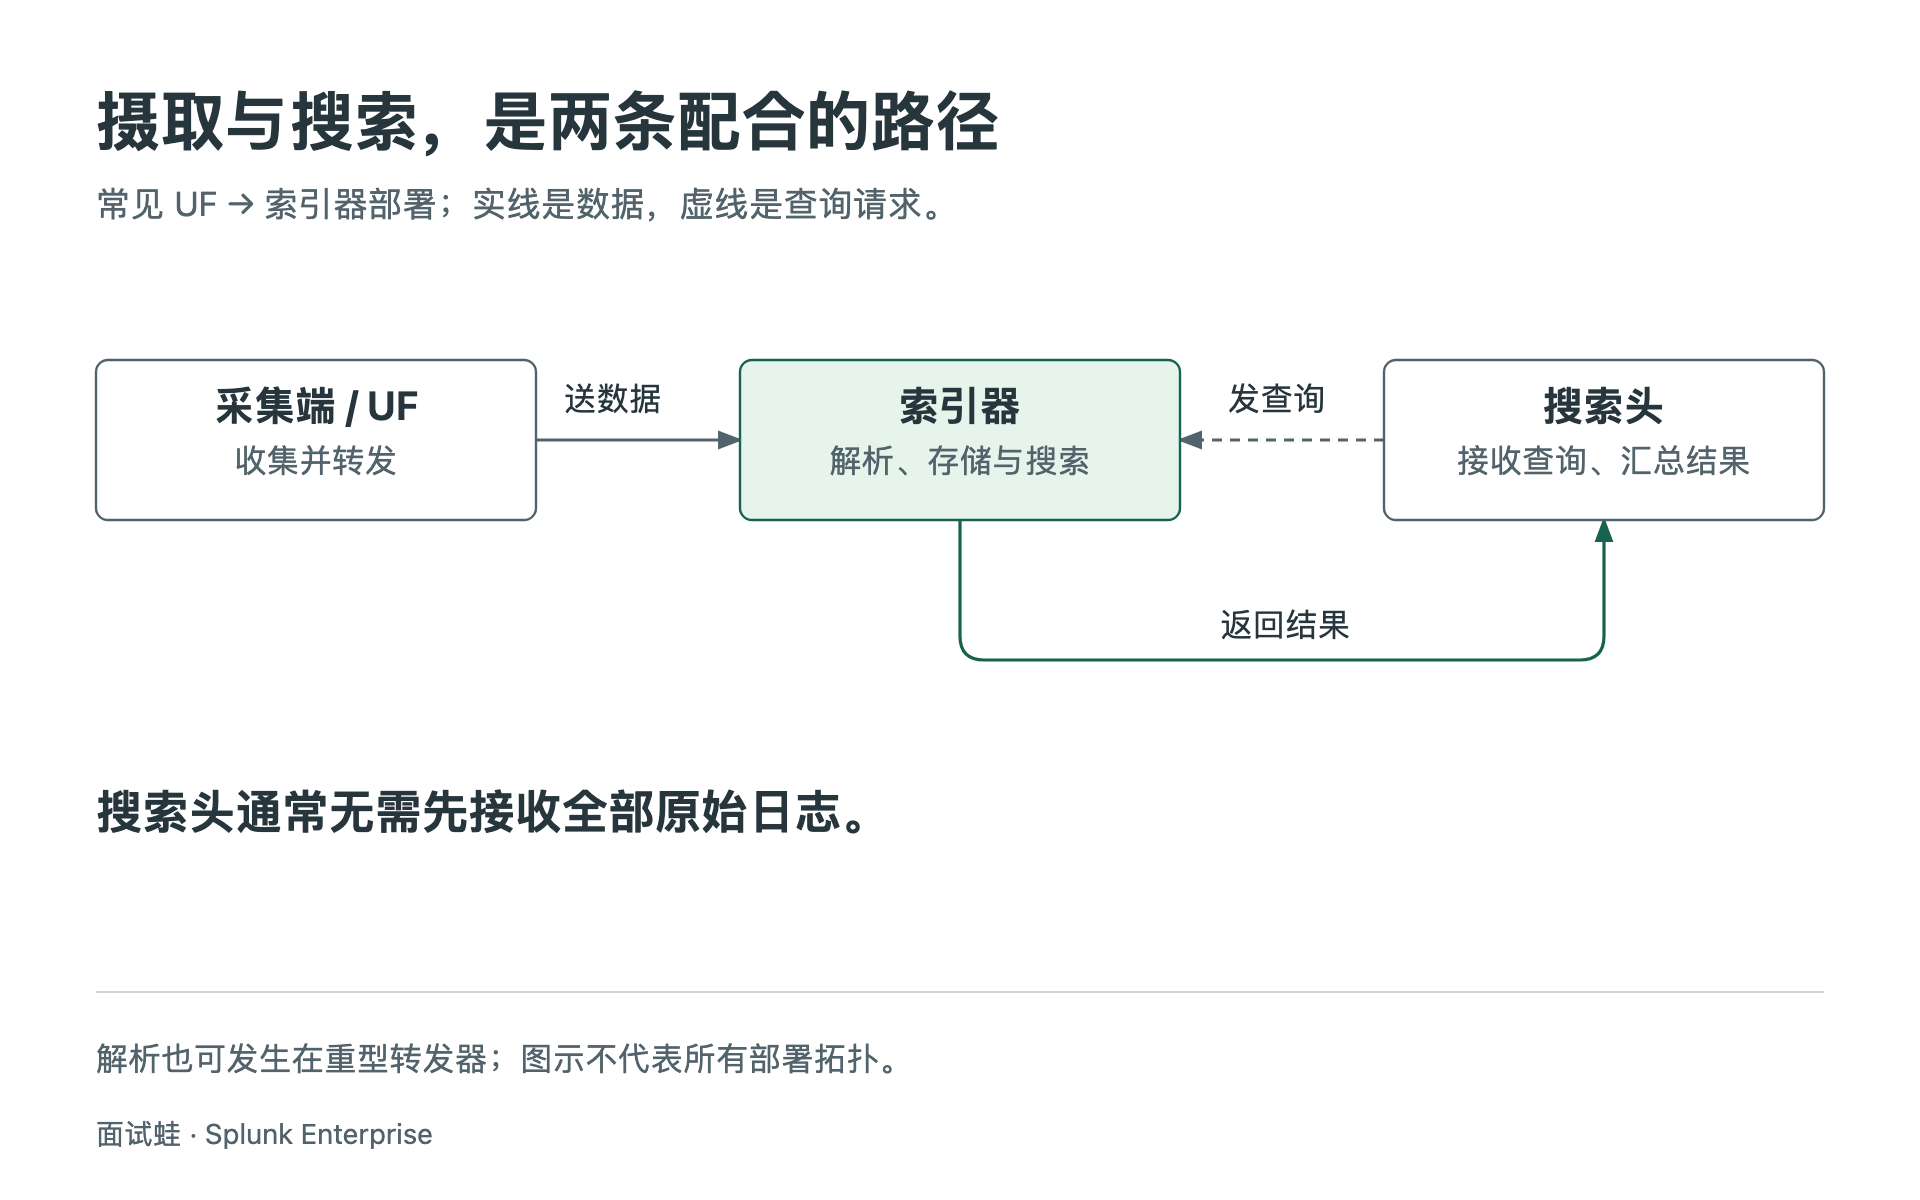
典型流程是接收数据,切分事件并识别时间,再建立索引、保存数据;查询时取出相关内容继续处理。搜索时还可以提取业务字段、过滤和统计。接收与搜索是两条配合的路径,搜索头通常不需要先接收所有原始日志。
讲清原理
以应用日志为例:采集端读文件,后面的解析环节判断哪里是一条事件、时间是什么,再由索引器把事件和索引文件写入存储。若多行异常被切成十条,后面的统计就可能从源头上出错。
用户发起查询时,搜索头把适合分发的工作交给相关索引器。索引器从本地数据中筛选或计算,搜索头再合并结果。业务字段不必全部预先写入索引;很多字段可以在搜索时从原文中提取。
例子与易错点
想查某订单的错误,先选对索引和时间范围,再按订单号、错误条件缩小结果。索引和时间范围能帮助少读一些无关数据。
若部署了重型转发器,解析可能发生在它那里;不能把所有解析配置都默认写到索引器,更不能写在任意一台搜索头上就期待摄取结果改变。
和评分标准对照,你能独立回答到哪一步?
自评会安排下一次复习,不保存你的口述内容。
这道题,你掌握得怎么样?
掌握程度由你主动标记,阅读和收藏不会自动改变状态。