索引时提取字段和搜索时提取字段有什么区别?
先说出你的答案
定义边界、关键机制、一个反例;P8题再补容量、失败与验证。
查看完整题解
参考回答
直接回答
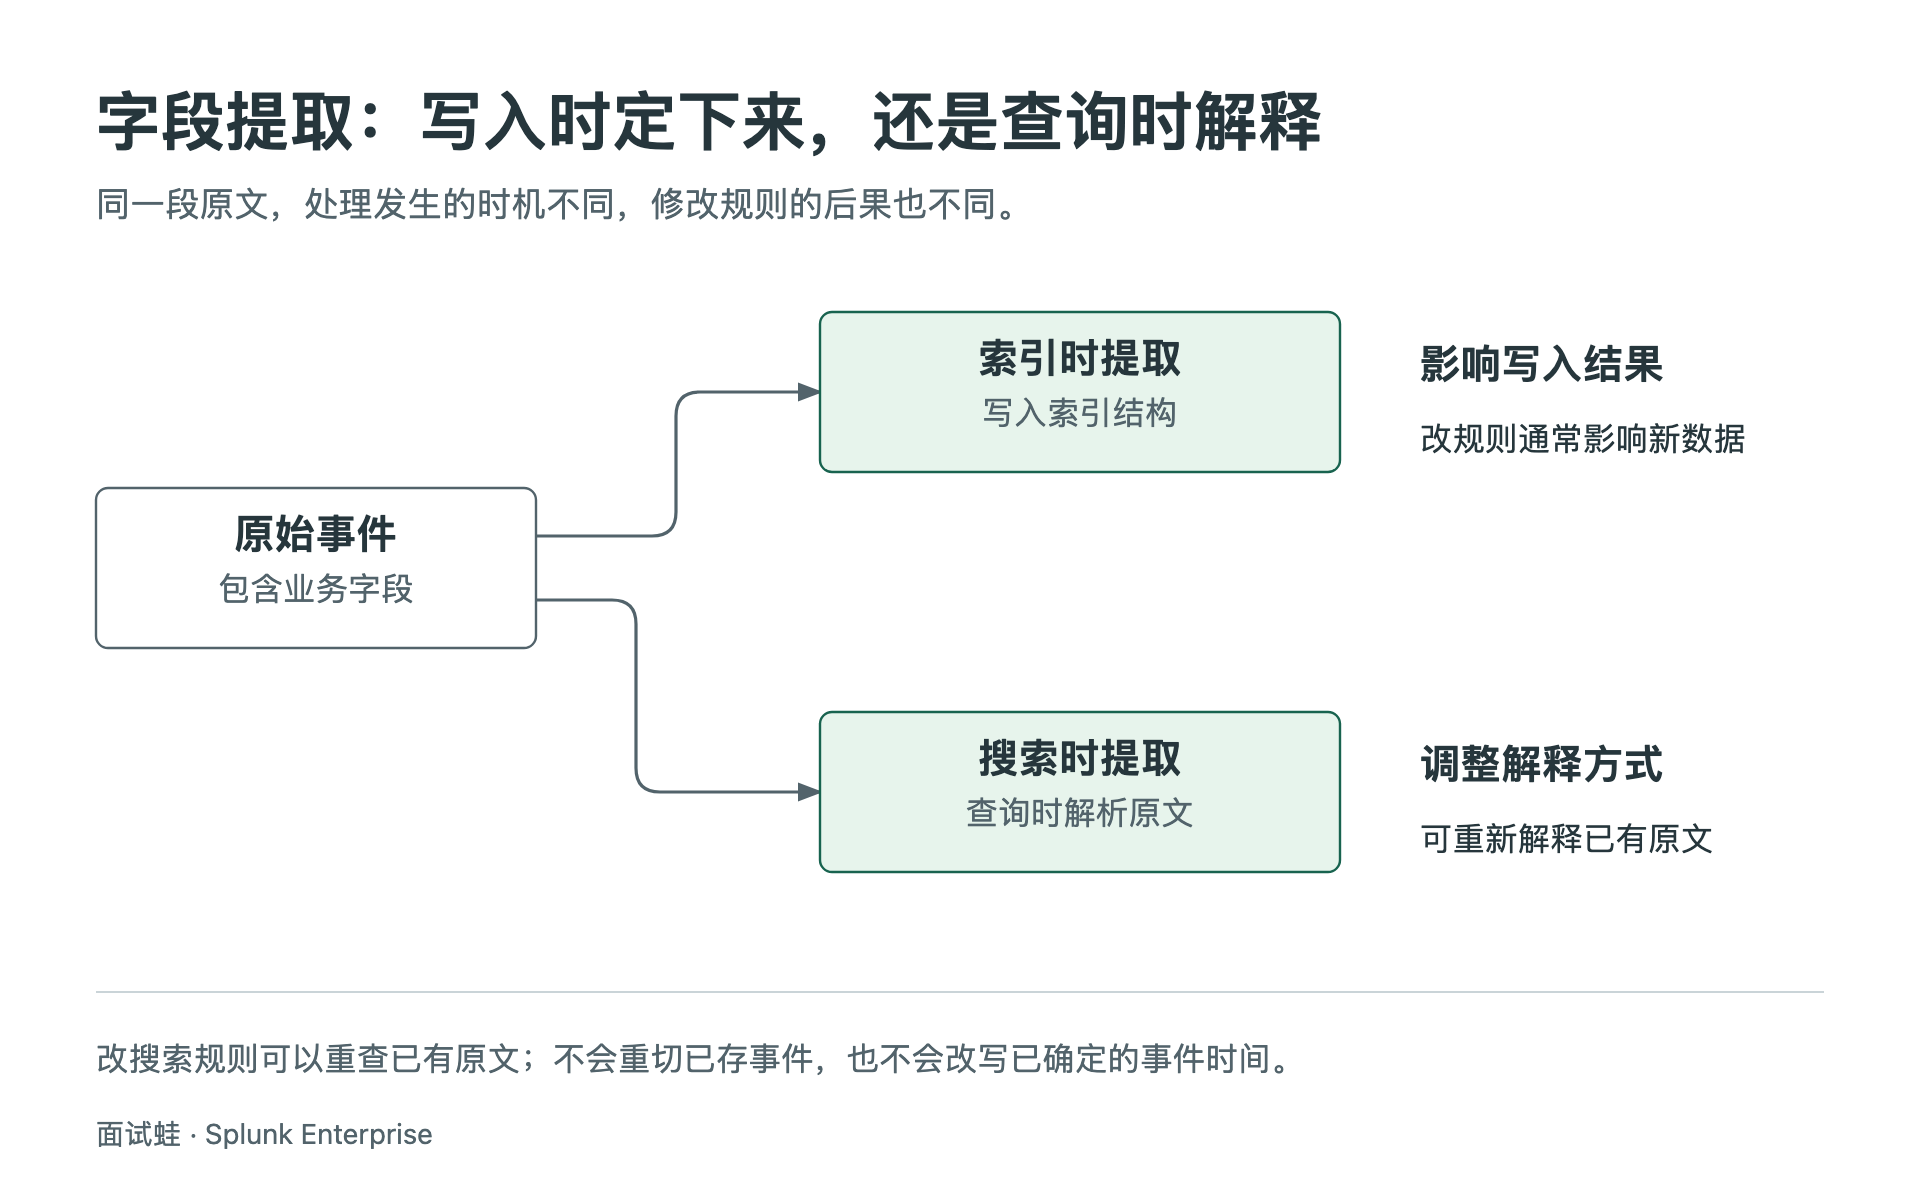
索引时提取发生在数据写入阶段,结果进入索引结构;搜索时提取是在查询时,从事件内容中解析字段。多数业务字段适合搜索时提取,便于调整规则。索引时加字段会增加处理和存储成本,不能简单理解成“提前提取,所以所有查询都更快”。
讲清原理
例如原文一直保留着订单号,搜索提取规则写错了,改好规则后可以重新搜索旧事件,不必重新摄取。但如果入库时就把多行事件切错、时间认错,修改一个搜索规则并不能把已经存储的事件重新拼回去。
因此要先判断错误发生在哪一步。索引阶段配置通常影响之后的新数据;需要改变历史数据的索引结果时,可能要从可靠原始来源重新摄取,并处理重复、容量和权限问题。
例子与易错点
原文是 order_id=A17,搜索时可以把 A17 提取成订单字段;后来业务字段改名,可调整对应规则。
不要把所有字段都设成索引时字段。对 JSON 等结构化输入,还要确认 INDEXED_EXTRACTIONS 与搜索时自动提取是否配合,避免同一内容被重复提取。
和评分标准对照,你能独立回答到哪一步?
自评会安排下一次复习,不保存你的口述内容。
这道题,你掌握得怎么样?
掌握程度由你主动标记,阅读和收藏不会自动改变状态。